

Para un medio de comunicación o portal digital donde la información cambia a cada hora, el impacto de no contar con este estándar se refleja en tres frentes críticos:
1. Menor prioridad en el rastreo de noticias del día
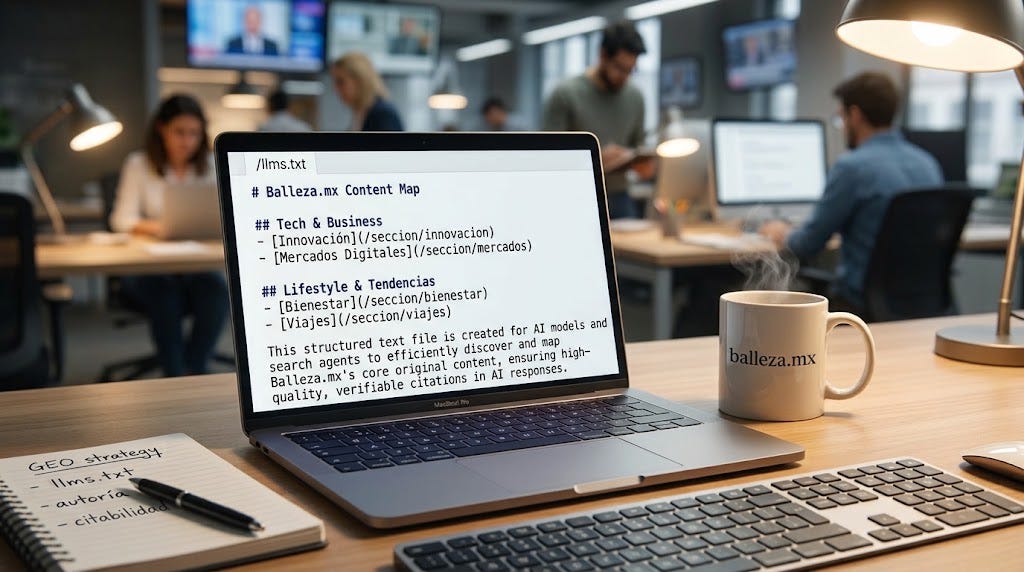
Los motores de búsqueda tradicionales dependen de los Sitemaps XML para descubrir publicaciones recientes. Sin embargo, los agentes de IA (como ChatGPT, Claude o Perplexity) prefieren consultar un archivo llms.txt ubicado en la raíz del servidor ([tublog.com/llms.txt](https://tublog.com/llms.txt)). Este archivo actúa como un mapa simplificado en formato Markdown.
Sin él, los bots de IA deben explorar el sitio “a ciegas”, lo que provoca retrasos de horas o incluso días para descubrir notas de última hora y utilizarlas en respuestas conversacionales.
2. Desperdicio del Crawl Budget (Presupuesto de Rastreo)
Los rastreadores de IA tienen un límite diario de peticiones por servidor. Sin una guía clara, gastan recursos procesando páginas secundarias, avisos legales, políticas de privacidad o archivos de etiquetas, en lugar de concentrarse en los artículos periodísticos principales.
3. Extracción de contexto incompleto o impreciso
El formato llms.txt permite incluir descripciones resumidas y directrices sobre la estructura del sitio. Sin estas instrucciones, las IAs extraen el texto directamente del HTML (rodeado de banners, menús y publicidad), aumentando el riesgo de omitir datos clave o citar a un competidor que tenga su contenido mejor organizado.
Ventajas y Desventajas de Implementar llms.txt
Ventajas
Priorización de contenido propio: Le indica a los modelos de lenguaje qué secciones contienen información primaria o local, evitando que pierdan tiempo en cables de agencias replicados.
Optimización de recursos del servidor: Al ofrecer un índice ligero en texto plano Markdown, se reducen la carga de transferencia y las peticiones innecesarias.
Contexto y atribución directa: Facilita que las respuestas generadas por IA identifiquen claramente la fuente original, aumentando la precisión de la cita.
Desventajas
Mantenimiento del índice: Aunque existen plugins para automatizar su creación, requiere mantener coherencia con la estructura de URLs del portal.
No garantiza citas al 100%: Es una guía estandarizada, pero la decisión final de citar sigue dependiendo del algoritmo de cada motor de respuesta.
Métricas Clave de GEO (Generative Engine Optimization) para Evaluar tu Dominio
Puntuación Compuesta GEO (Composite GEO Score): Escala global de 0 a 100 que mide la preparación general de un sitio para ser indexado y citado por modelos de lenguaje.
Puntuación de Citabilidad (Citability Score): Evalúa si la redacción de tus párrafos tiene la densidad de datos requerida para ser citada como fuente factual. (Un nivel inferior a 40 indica que el contenido es demasiado narrativo o disperso).
Acceso de Rastreadores de IA (AI Crawler Access): Estado de permisos en tu robots.txt para rastreadores clave como GPTBot, PerplexityBot, ClaudeBot, ByteSpider y PetalBot.
Formato Estructurado de Extracción: Longitud óptima de bloques explicativos (secciones independientes de entre 134 y 167 palabras) estructuradas con respuestas directas al inicio (Answer-First).
El Cambio de Paradigma en Cifras
Para comprender la urgencia de adaptar nuestros portales digitales a los requerimientos de la Inteligencia Artificial, basta con observar las cifras globales del mercado publicitario y de consumo digital destacadas por BCN (Brand Community Network):
80% de los consumidores ya utilizan las respuestas generadas por Inteligencia Artificial de forma directa sin llegar a hacer clic hacia un sitio web externo (Zero-Click Searches).
Menos del 10% de las fuentes citadas por los modelos de lenguaje (LLMs) corresponden a sitios web oficiales o de marca; los motores de respuesta priorizan medios con alta autoridad de dominio y cobertura editorial.
50% de los usuarios de internet emplean herramientas de IA (como ChatGPT, Perplexity o Google AI Overviews) como su canal habitual para realizar búsquedas de información.
Frente a esta realidad, incorporar estándares como el archivo llms.txt, optimizar la citabilidad del contenido y mantener estructuras claras de respuesta deja de ser un experimento técnico para convertirse en una estrategia indispensable para proteger el tráfico y la relevancia de cualquier medio digital.
_
Fuente: Bain & Company study, 2025; McKinsey study, 2025; Bitkom study, 2025